Wissen für den Mittelstand · Experimentieren und entscheiden
Ein neuer Button bringt mehr Anfragen. Eine andere Betreffzeile erzeugt mehr Klicks. Solche Aussagen klingen eindeutig. Ob die Änderung die Verbesserung tatsächlich verursacht hat, lässt sich aber erst mit einem sauber geplanten Vergleich beurteilen. Dieser Leitfaden führt dich von der geschäftlichen Frage bis zur Entscheidung – einschließlich Stichprobe, Zufallszuweisung, Datenqualität, Statistik und Wirtschaftlichkeit.
Du erfährst auch, wann ein A/B-Test für dein Unternehmen zu wenig Aussagekraft hat und wie du dann trotzdem sinnvoll weiterkommst. Die Empfehlungen verbinden wissenschaftliche Methoden mit einer umsetzbaren Arbeitsweise für kleine und mittlere Unternehmen.
Umfassend überarbeitet und Quellen geprüft: 28. Oktober 2026.
Was ein A/B-Test leisten kann
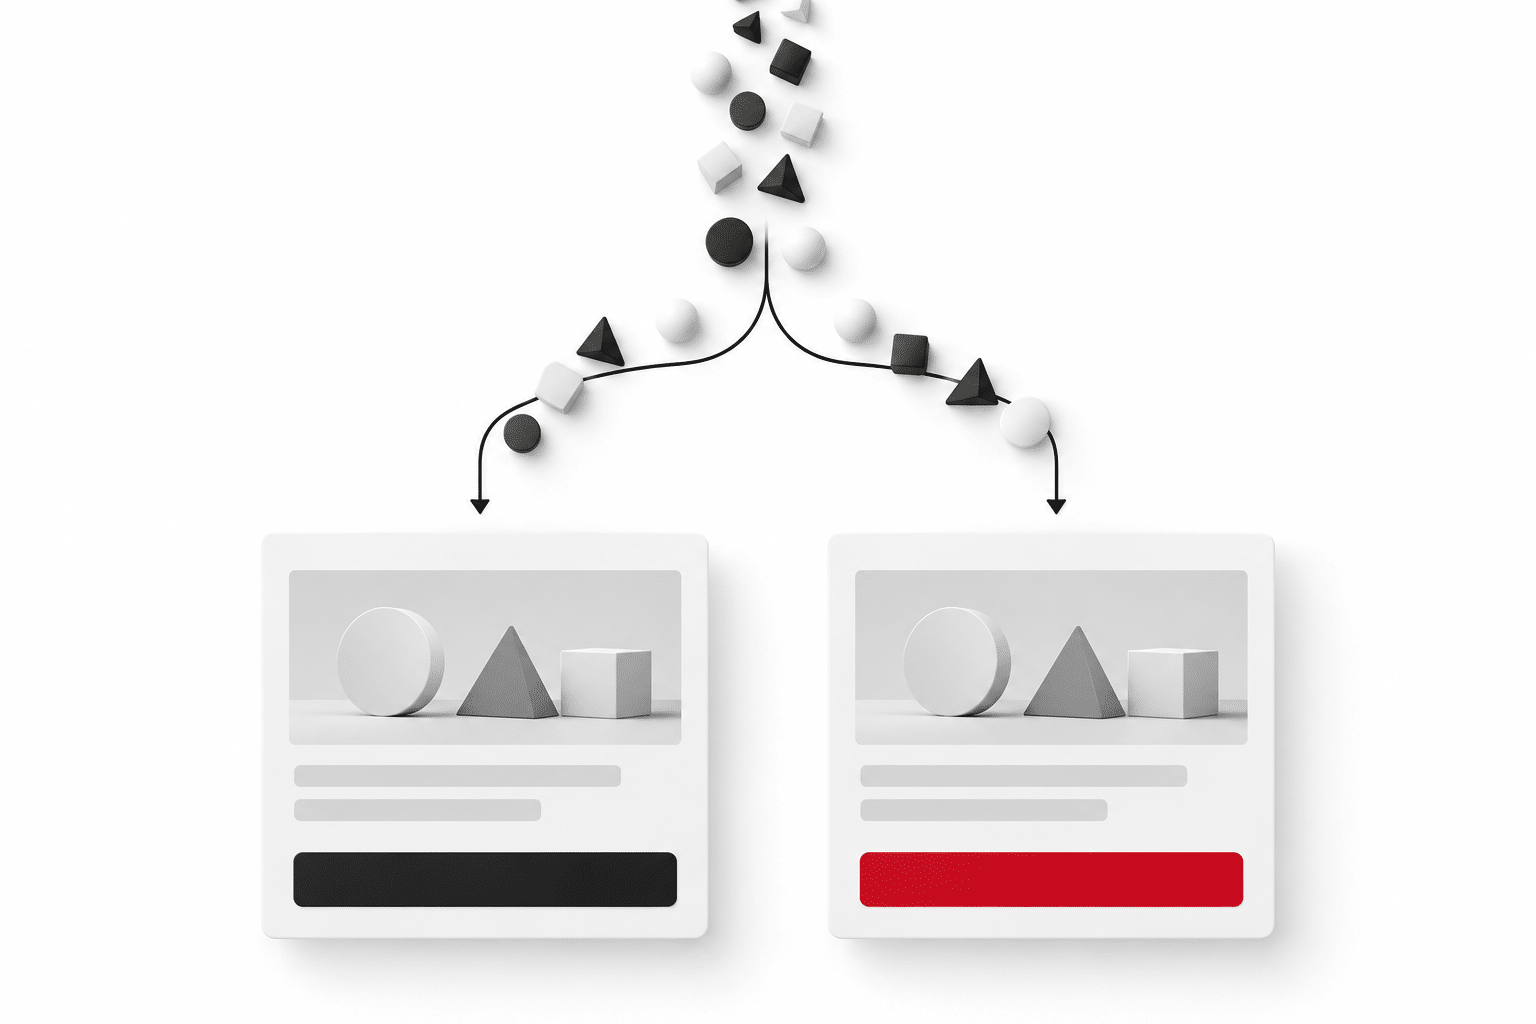
Bei einem kontrollierten A/B-Test erhält eine zufällig ausgewählte Gruppe die bestehende Variante A, eine andere die Variante B. Beide laufen möglichst im gleichen Zeitraum unter vergleichbaren Bedingungen. Die Zufallszuweisung soll bekannte und unbekannte Einflussfaktoren im Mittel ausgleichen. So wird eine ursächliche Interpretation möglich, wenn Umsetzung, Messung und Auswertung zum Versuchsplan passen. [1]
Ein Vorher-nachher-Vergleich kann dagegen durch Saison, Werbedruck, Preise, Wettbewerb oder die Zusammensetzung der Besucher beeinflusst sein. Auch zwei getrennte Werbekampagnen sind nicht automatisch ein Experiment: Wenn ein Auslieferungsalgorithmus unterschiedliche Menschen auswählt, sind die Gruppen womöglich schon vor dem Kontakt verschieden. Nutze dafür eine echte Experimentfunktion mit dokumentierter Zuteilung.
A/B, Mehrvarianten- und multivariate Tests
A/B bezeichnet zunächst zwei Varianten. Ein Test mit A, B und C ist ein Mehrvariantentest. Ein faktorieller beziehungsweise multivariater Versuch variiert mehrere Faktoren systematisch und kann deren Zusammenspiel untersuchen. Dafür braucht es einen passenden Versuchsplan und meist mehr Daten. Ein kompletter Seitenneuentwurf gegen die bisherige Seite ist ebenfalls testbar; das Ergebnis erklärt dann die Wirkung des Gesamtpakets, nicht die Wirkung jedes einzelnen Elements.
Von der Geschäftsfrage zur prüfbaren Hypothese
Beginne mit einem Problem, für das eine Entscheidung ansteht. „Wir brauchen mehr Leads“ ist zu offen. Konkreter ist: „Interessenten verstehen den Aufwand einer Erstberatung nicht. Wenn wir Dauer, Ablauf und Ergebnis direkt am Formular erklären, steigt der Anteil qualifizierter Terminanfragen, ohne dass die Quote nicht wahrgenommener Termine zunimmt.“
Dokumentiere Zielgruppe, vermutete Hürde, Änderung, Wirkmechanismus, Hauptkennzahl und Entscheidungsschwelle. Trenne eine fachliche Begründung von einer nachträglichen Erklärung für einen zufällig guten Wert. Ein vorab ausgefüllter Versuchsplan macht Ergebnisse auch dann nutzbar, wenn die Idee nicht gewinnt.
| Planungsfrage | Beispiel für eine B2B-Landingpage |
|---|---|
| Wer nimmt teil? | Neue, berechtigte Besucher der Beratungsseite; interne Zugriffe und bekannte Bots nach vorab festgelegter Regel ausgeschlossen. |
| Was wird verändert? | B ergänzt eine kurze Ablaufbeschreibung. Angebot, Preis und Formular bleiben im geplanten Vergleich ansonsten gleich. |
| Was entscheidet? | Anteil der zugeteilten Personen mit einer qualifizierten Anfrage innerhalb von 14 Tagen. |
| Was darf nicht schlechter werden? | Fehlermeldungen, Ladezeit und Anteil unpassender oder nicht wahrgenommener Termine. |
| Was wird vorab festgelegt? | Zuteilung, Mindestwirkung, Stichprobe, Laufzeitregeln, Auswertungsverfahren, Kosten und Verantwortliche. |
Priorisiere nach erwartbarem Nutzen, Stärke der Problembelege, Reichweite und Aufwand. Kundenfragen, Formularabbrüche und Nutzungsbeobachtungen liefern bessere Ausgangspunkte als die bloße Vorliebe für eine andere Farbe. Diese Priorisierung ist eine praktische Empfehlung und keine wissenschaftlich garantierte Erfolgsformel.
Die richtige Einheit: Mensch, Unternehmen oder Sitzung?
Die Zuteilungseinheit bestimmt, wer unabhängig voneinander einer Variante zugewiesen wird. Bei vielen Website-Tests ist eine Person beziehungsweise eine stabile Nutzerkennung sinnvoll. Eine Person sollte nicht bei jedem Besuch die Variante wechseln. Sonst vermischen sich Erfahrungen, und wiederkehrende Besuche werden leicht wie unabhängige Menschen behandelt. [1]
Im B2B können mehrere Personen aus einem Unternehmen gemeinsam entscheiden. Bei Preisen, Account-Betreuung oder gemeinsam genutzten Produkten kann deshalb eine Zuteilung auf Unternehmensebene nötig sein. Bei regionalen Maßnahmen kommen Regionen als Einheiten infrage. Solche Gruppen sind häufig intern ähnlich; die Fallzahl unabhängiger Einheiten ist dann kleiner als die Zahl der Sitzungen oder Kontakte. Planung und Standardfehler müssen diese Struktur berücksichtigen. [2]
Gleiche Chancen und dauerhafte Zuordnung
Eine gleichmäßige Aufteilung nutzt eine gegebene Gesamtstichprobe bei ähnlicher Streuung meist effizient. Eine vorsichtigere Verteilung, etwa 90 zu 10, kann betrieblich sinnvoll sein, verändert aber die nötige Stichprobe. Dokumentiere die geplante Quote. Verbinde Kennungen nur auf einer passenden rechtlichen und technischen Grundlage; ein geräteübergreifender Abgleich entsteht nicht automatisch aus einem Cookie.
Definiere außerdem, wer teilnehmen darf und wann die Zuteilung erfolgt. Wenn eine Variante selbst beeinflusst, ob ein Ereignis protokolliert wird, ist ein Vergleich ausschließlich dieser protokollierten Nutzer verzerrungsanfällig. Ein stabiler gemeinsamer Einstiegspunkt hilft, die Gruppen vollständig zu erfassen.
Hauptkennzahl, Schutzkennzahlen und Messfenster
Eine Hauptkennzahl macht die zentrale Entscheidung eindeutig. Für einen Shop kann das Deckungsbeitrag pro zugeteilter Person sein; für eine Beratung der Anteil qualifizierter Anfragen. Klicks oder Formularstarts können frühe Hinweise liefern, sind aber kein Ersatz für den Geschäftserfolg. Wissenschaftliche Arbeiten zur Online-Experimentierung unterscheiden entsprechend Ziel-, Schutz- und Diagnosekennzahlen. [2]
Schutzkennzahlen begrenzen Schäden: Beschwerden, Stornos, technische Fehler, Wartezeiten oder eine sinkende Leadqualität. Diagnosekennzahlen erklären Abläufe. Eine Variante, die Klicks steigert, aber häufiger falsche Erwartungen weckt, kann wirtschaftlich schlechter sein. Lege fest, wie eine kritische Verschlechterung behandelt wird; viele Schutzkennzahlen erzeugen ebenfalls mehrere statistische Prüfungen.
Der Nenner gehört zur Kennzahl
Schreibe die Berechnung aus: „Personen mit mindestens einer Bestellung innerhalb von sieben Tagen geteilt durch alle berechtigt zugeteilten Personen.“ Das verhindert, dass A nach Sitzungen und B nach Personen bewertet wird. Bei Umsatz pro Person gehören auch Nullumsätze in den Nenner. Umsatz pro Käufer beantwortet eine andere Frage und kann steigen, obwohl insgesamt weniger Menschen kaufen. Solche Nenner- und Auswahlprobleme sind eine bekannte Quelle falscher Schlussfolgerungen. [7]
Plane das Beobachtungsfenster nach deinem Geschäftsprozess. Wenn zwischen Anfrage und Abschluss mehrere Wochen liegen, lässt sich der endgültige Umsatz nicht schon am zweiten Tag belastbar vergleichen. Verwende eine frühe Ersatzkennzahl nur, wenn ihre Beziehung zum späteren Ziel fachlich und empirisch ausreichend begründet ist. Prüfe nachgelagerte Ergebnisse später nach.
Stichprobe planen: Ausgangsrate, Mindestwirkung und Teststärke
Die nötige Stichprobe hängt von der Ausgangsrate, dem interessierenden Unterschied, dem Signifikanzniveau, der gewünschten Teststärke und dem Versuchsaufbau ab. Die kleinste relevante Wirkung ist eine fachliche Entscheidung: Welcher zusätzliche Nutzen rechtfertigt Einführung und Betrieb? Die statistisch nachweisbare Mindestwirkung beschreibt dagegen, was ein geplanter Test unter seinen Annahmen mit einer bestimmten Wahrscheinlichkeit erkennen kann. Beides sollte zusammenpassen. [3]
Das Signifikanzniveau α begrenzt bei einem passenden Verfahren die langfristige Fehlerwahrscheinlichkeit, einen Effekt zu melden, obwohl die geprüfte Nullhypothese gilt. Die Teststärke, häufig 80 oder 90 Prozent, beschreibt die Chance, einen bestimmten tatsächlich vorhandenen Effekt zu erkennen. Sie ist keine Garantie für den einzelnen Versuch. Kleine Änderungen an seltenen Ereignissen benötigen oft überraschend große Stichproben.
Fiktives Planungsbeispiel
Wir nehmen eine Ausgangsrate von 2,0 Prozent und eine Zielrate von 2,4 Prozent an. Das sind 0,4 Prozentpunkte beziehungsweise 20 Prozent relativ. Ein vereinfachter zweiseitiger Vergleich zweier unabhängiger Anteile mit α = 5 Prozent, 80 Prozent Teststärke und gleicher Aufteilung ergibt rund 21.110 Personen je Variante. Die Berechnung nutzt eine Normalapproximation ohne Kontinuitätskorrektur. Ein anderes Verfahren, Cluster oder unsichere Ausgangsraten können andere Anforderungen ergeben. [9]
Bei 1.000 tatsächlich berechtigten neuen Personen pro Tag wären für beide Gruppen zusammen rechnerisch gut 42 Tage nötig. Hinzu kommen ein vollständiges Beobachtungsfenster und die Abdeckung relevanter Geschäftszyklen. Sitzungen, Bots und wiederkehrende Personen sind kein Ersatz für unabhängige Teilnehmer. Rechne bei unsicherer Ausgangsrate mehrere plausible Szenarien durch.
Wie lange ein A/B-Test laufen sollte
Die Laufzeit folgt dem Datenbedarf und dem Geschäftsprozess. Eine feste Zwei-Wochen-Regel ist weder eine Garantie für Aussagekraft noch für einen fairen Vergleich. Berücksichtige Wochenmuster, Kampagnen, Lieferfähigkeit, Abrechnungszyklen und die Zeit bis zur Conversion. Mehrere volle Wochen können sinnvoll sein; bei wenig Reichweite reichen sie trotzdem nicht aus.
Beim klassischen festen Versuchsplan legst du die Stichprobe beziehungsweise die zulässige Beendigungsregel vorher fest. Du kannst währenddessen Fehler und Sicherheitskennzahlen beobachten. Beendest du den Test aber bei der ersten günstigen gewöhnlichen Signifikanzanzeige, passt die ausgewiesene Fehlerwahrscheinlichkeit nicht mehr zum tatsächlich verwendeten Verfahren. Für wiederholte Zwischenentscheidungen braucht es ein entsprechend geplantes sequenzielles Verfahren. [5]
Warte nach dem Ende der Aufnahme neuer Teilnehmer gegebenenfalls noch, bis das festgelegte Conversion-Fenster für alle Gruppen ausgereift ist. Dokumentiere Ausfälle, Feiertage und parallele Änderungen. Verändere nicht mitten im Versuch die Variante, die Zielgruppe oder den Erfolgshorizont und werte anschließend alles wie einen unveränderten Test aus.
Auch ein langer Versuch beantwortet zunächst die Frage nach dieser Zielgruppe in diesem Zeitraum. Neue Preise, eine andere Saison oder ein anderes Angebot können die Wirkung verändern. Bei teuren, langfristigen Entscheidungen ist eine spätere Wiederholung oder ein schrittweiser Rollout mit weiterem Monitoring sinnvoll.
Vor dem Ergebnis: Zuteilung und Datenqualität prüfen
Teste beide Varianten auf echten Endgeräten: Darstellung, Ladezeit, Formular, Zahlung, Weiterleitung und Messung. Prüfe, ob Events einmalig, mit derselben Definition und derselben Zeitbasis erfasst werden. Interne Tests, bekannte Bots und fehlerhafte Datensätze müssen nach vorher festgelegten, in beiden Gruppen vergleichbaren Regeln behandelt werden.
Was ein Sample Ratio Mismatch bedeutet
Bei geplanter 50:50-Verteilung sind exakt gleiche Fallzahlen nicht zu erwarten. Ein Sample Ratio Mismatch ist eine statistisch auffällige Abweichung von der vorgesehenen Zuteilung. Mögliche Ursachen sind technische Zuteilungsfehler, unterschiedliche Erfassung, selektive Filter oder ein durch die Variante beeinflusster Zugang zur Messung. Die Diagnose muss vor der Wirkungsaussage erfolgen. Die Forschungsarbeiten von Fabijan und Kollegen beschreiben dafür eine systematische Fehlersuche. [6]
A/A-Test und vollständige Auswertung
Ein A/A-Test verteilt identische Inhalte auf zwei Gruppen. Er kann Probleme in Zuteilung, Protokollierung oder Auswertung sichtbar machen. Ein einzelner unauffälliger A/A-Test beweist aber nicht, dass das System in jedem Szenario korrekt funktioniert.
Eine Auswertung nach ursprünglicher Zuteilung, häufig Intention-to-treat genannt, erhält den Vorteil der Randomisierung. Personen nachträglich auszuschließen, weil sie nicht geklickt oder eine bestimmte Funktion nicht genutzt haben, kann die Gruppen unterschiedlich zusammensetzen. Falls eine Auswertung nur tatsächlich exponierter Personen vorgesehen ist, müssen gemeinsamer Auslöser, Selektionsmechanismus und Zielaussage ausdrücklich geprüft werden. [2]
Effekt, Konfidenzintervall und p-Wert richtig lesen
Berichte zunächst die Rohzahlen und Raten, dann den absoluten Unterschied und die relative Veränderung. Von 2 auf 2,4 Prozent sind es plus 0,4 Prozentpunkte und plus 20 Prozent relativ. Die relative Zahl wirkt größer, beschreibt aber denselben Unterschied. Ohne Ausgangswert und Nenner ist sie leicht missverständlich.
Ein Konfidenzintervall zeigt die Präzision einer Schätzung unter dem gewählten Modell. Ein 95-Prozent-Verfahren erzeugt bei vielen Wiederholungen unter seinen Voraussetzungen Intervalle, die in 95 Prozent der Fälle den wahren Parameter enthalten. Es bedeutet im klassischen Verständnis nicht, dass der Parameter nach der Berechnung mit 95 Prozent Wahrscheinlichkeit in diesem einen Intervall liegt.
Der p-Wert beschreibt, wie unvereinbar die Daten mit der geprüften Nullhypothese und den weiteren Modellannahmen sind. Er ist weder die Wahrscheinlichkeit, dass die Nullhypothese wahr ist, noch die Größe oder der wirtschaftliche Wert eines Effekts. Die American Statistical Association warnt ausdrücklich davor, Entscheidungen allein an einer Schwelle wie 0,05 festzumachen. [4]
Für Entscheidungen helfen drei Fragen: Welche Wirkung wurde geschätzt? Welche relevanten Gewinne oder Schäden sind mit den Daten noch vereinbar? Welches Risiko können wir bei den Kosten einer Einführung tragen? Ein kleines statistisch auffälliges Plus kann unprofitabel sein. Ein größerer, aber unpräziser Schätzwert kann weitere Daten rechtfertigen.
Ein vollständiges Beispiel: 20 Prozent mehr, trotzdem kein klarer Sieger
Die folgende Rechnung ist fiktiv. Beide Varianten erhalten je 10.000 unabhängig zugeteilte Personen. A erzielt 200 Conversions, B erzielt 240. Wir verwenden zur Veranschaulichung einen zweiseitigen gepoolten Anteilstest und für die Differenz ein Normalintervall mit getrennt geschätzten Gruppenvarianzen. Bei kleinen Ereigniszahlen wären diese Näherungen nicht ohne Weiteres geeignet.
| Größe | Variante A | Variante B beziehungsweise Unterschied |
|---|---|---|
| Personen | 10.000 | 10.000 |
| Conversions | 200 | 240 |
| Conversion-Rate | 2,00 % | 2,40 % |
| Absoluter Unterschied | Referenz | +0,40 Prozentpunkte |
| Relative Veränderung | Referenz | +20 % |
| 95-%-Intervall der Differenz | — | etwa −0,007 bis +0,807 Prozentpunkte |
| Zweiseitiger p-Wert | — | etwa 0,054 |
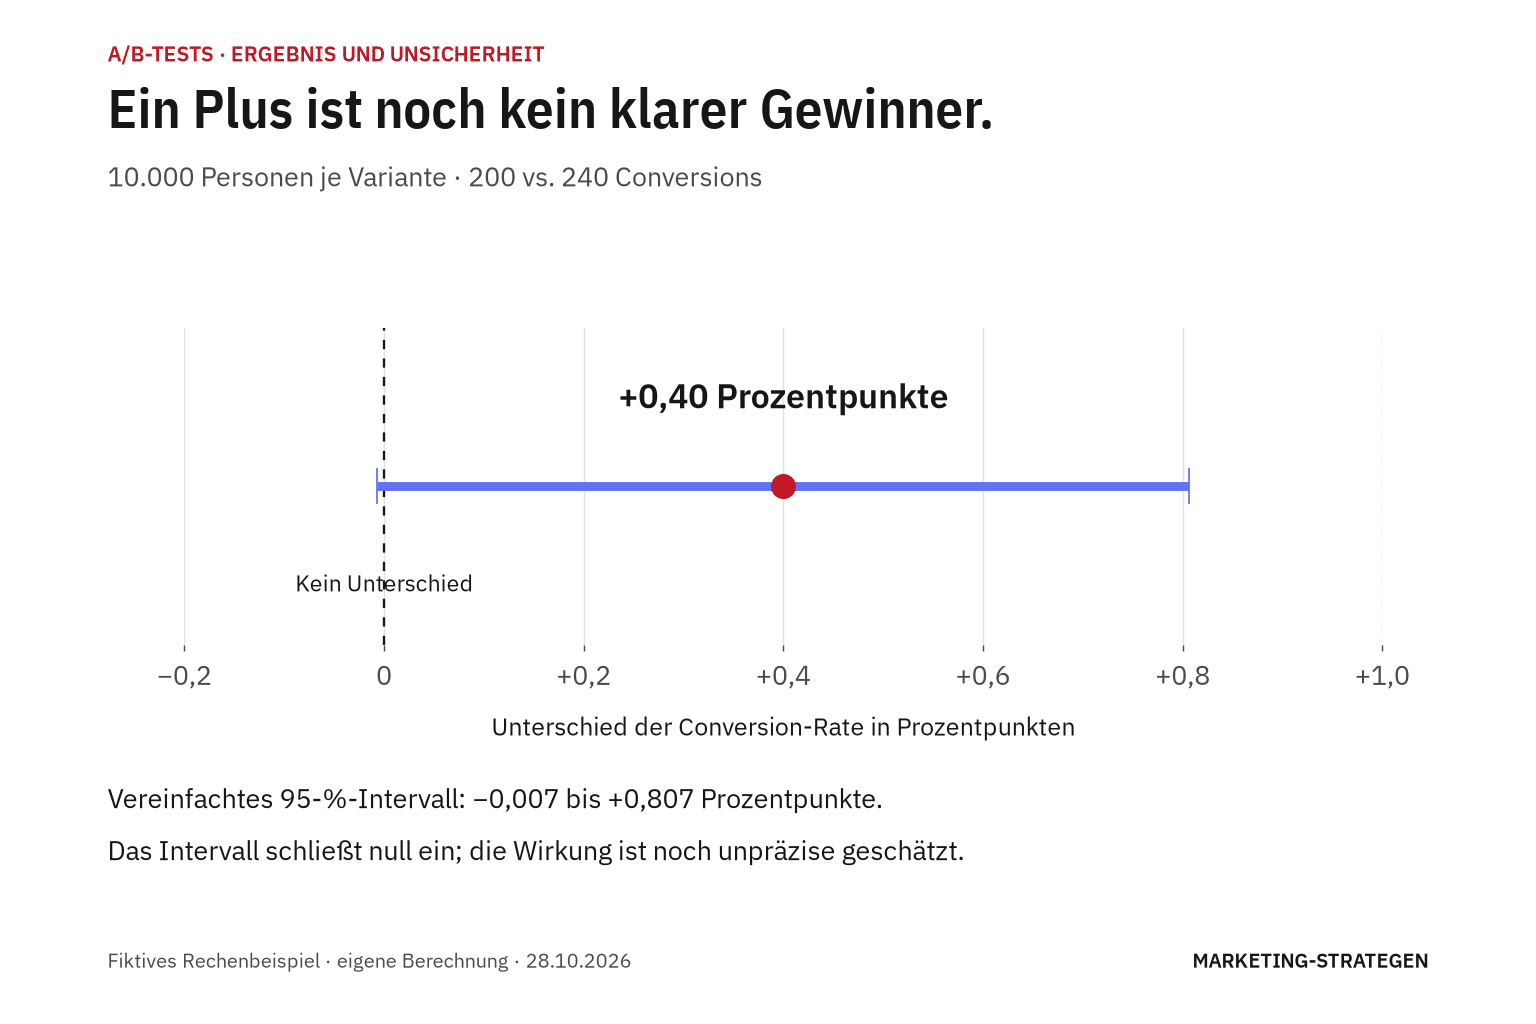
Die Schätzung spricht in Richtung B. Das Intervall ist aber auch mit einer sehr kleinen negativen Wirkung vereinbar. Nach einer vorab festgelegten klassischen Fünf-Prozent-Regel wäre das kein eindeutiger Wirksamkeitsnachweis. Es wäre ebenso falsch zu behaupten, die Varianten seien gleich gut.
Ein nachträgliches „Wir brauchen nur noch ein paar Conversions“ mit erneuter täglicher Prüfung löst das Problem nicht sauber. Prüfe den ursprünglichen Plan. Eine Fortsetzung kann methodisch möglich sein, benötigt aber eine dazu passende Auswertungsregel oder einen klar getrennten Folgetest. Vermeide, ein ungeplantes Ergebnis im Nachhinein als vorab geplanten Erfolg darzustellen.
Rechenweg zur Einordnung
Die Differenz ist 240/10.000 minus 200/10.000. Für das dargestellte Intervall wird ihr Standardfehler näherungsweise als Quadratwurzel aus der Summe pA × (1 − pA)/nA + pB × (1 − pB)/nB berechnet und mit 1,96 multipliziert. Das ist eine transparente Lehrrechnung, kein universelles Verfahren für jede Datenlage. Geeignete Score-, exakte, Cluster- oder sequenzielle Verfahren können zu abweichenden Grenzen führen.
Mehrere Varianten, Zwischenstände und nachträgliche Segmente
Wenn du viele Varianten, Kennzahlen und Untergruppen prüfst und nur den besten Treffer meldest, steigt die Gefahr eines Zufallsfundes. Plane deshalb, welche Vergleiche die Entscheidung tragen. Bei mehreren bestätigenden Tests kann beispielsweise das Holm-Verfahren die Fehlerwahrscheinlichkeit über die Testfamilie kontrollieren. Verfahren zur Kontrolle der Falschentdeckungsrate, etwa Benjamini–Hochberg, verfolgen ein anderes Ziel. Die Wahl hängt vom Entscheidungsproblem und den Voraussetzungen ab. [10]
Ein Ergebnis bei mobilen Nutzern ist besonders vorsichtig zu bewerten, wenn diese Untergruppe erst nach einem insgesamt unklaren Ergebnis ausgewählt wurde. Dass ein Effekt in einer Gruppe statistisch auffällig ist und in einer anderen nicht, beweist noch keinen Unterschied zwischen den Gruppen. Dafür ist ein geeigneter direkter Interaktionsvergleich nötig. Kennzeichne nachträgliche Analysen als explorativ und prüfe wichtige Vermutungen in einem neuen Versuch.
Sequenziell und bayessch sind keine Abkürzungen ohne Regeln
Sequenzielle Verfahren berücksichtigen wiederholte Auswertungen im Design. Die Arbeit von Johari und Kollegen entwickelt dafür jederzeit gültige Inferenzverfahren. Das gilt nicht automatisch für jedes Dashboard, das seine Zahlen laufend aktualisiert. [5]
Bayessche Verfahren verbinden eine vorher festgelegte Vorannahme mit den beobachteten Daten. Sie können posteriorbasierte Entscheidungsgrößen liefern. Aussage und Ergebnis hängen von Modell, Vorannahme, Verlustfunktion und Auswahlprozess ab. Frage beim Werkzeug nach diesen Annahmen und der Stoppregel. Auch eine bayessche Anzeige verhindert weder schlechte Daten noch selektive Berichterstattung.
Fortgeschrittene Fallstricke mit großer praktischer Wirkung
Neuheit und langfristige Folgen
Eine neue Funktion kann anfangs auffallen und später an Wirkung verlieren. Umgekehrt brauchen neue Abläufe Eingewöhnung. Ein kurzfristiger Klickgewinn sagt deshalb nicht zwingend etwas über Wiederkäufe oder langfristige Nutzung. Wissenschaftliche Arbeiten zur Experimentierung behandeln diesen Unterschied zwischen kurzfristigen Messgrößen und langfristigen Zielen ausdrücklich. [2]
Ausreißer, Geldbeträge und Verhältniskennzahlen
Umsätze sind häufig stark schief verteilt. Ein großer Auftrag kann einen kleinen B2B-Test dominieren. Lösche ihn nicht erst dann, wenn er „stört“. Lege Datenbereinigung und robuste Auswertung vorher fest. Bei Umsatz pro Sitzung oder anderen Quotienten muss die Unsicherheit zur Abhängigkeit von Zähler und Nenner passen. Ein einfacher Test über einzelne Bestellwerte beantwortet nicht automatisch die Frage nach Umsatz pro zugeteilter Person.
Gegenseitige Beeinflussung
Gemeinsame Lagerbestände, Vertriebsteams, Haushalte oder Unternehmensaccounts können Gruppen verbinden. Wenn eine Variante ein knappes Produkt schneller verbraucht, verschlechtert sie möglicherweise die Verfügbarkeit für die andere. Dann ist die Annahme voneinander unbeeinflusster Einheiten fraglich. Prüfe Gruppenrandomisierung oder einen fachlich geplanten alternativen Versuchsaufbau.
Unterschied zwischen „kein Beleg“ und „gleichwertig“
Wenn Gleichwertigkeit das Ziel ist, etwa bei einer günstigeren technischen Umsetzung, braucht es vorab definierte tolerierbare Abweichungen und ein dafür geeignetes Äquivalenz- oder Nichtunterlegenheitsverfahren. Ein gewöhnlicher nicht signifikanter Unterschied reicht nicht. Lakens erläutert dieses Grundproblem für Äquivalenztests; das konkrete Verfahren muss zum Kennzahlentyp passen. [8]
Vom Testergebnis zur wirtschaftlichen Entscheidung
Übersetze den geschätzten Effekt in einen vorsichtigen Geschäftswert: zusätzlicher Deckungsbeitrag pro berechtigter Person mal erwartete Reichweite, abzüglich Einführungs-, Betriebs- und Folgekosten. Berücksichtige Retouren, Rabatte, Vertriebskapazität und mögliche Qualitätsverluste. Rechne nicht ausschließlich mit zusätzlichem Umsatz.
Verwende mehrere Szenarien aus dem Unsicherheitsbereich. Eine leicht rücknehmbare Textänderung lässt sich mit anderem Risiko einführen als ein neues Preismodell. Dokumentiere, warum du einführst, weiter testest oder verwirfst. Nach Einführung solltest du zentrale Schutzkennzahlen weiter beobachten; ein Rollout in eine andere Zielgruppe ist eine neue Annahme.
Die Forschung zur Werbewirkungsmessung zeigt, wie schwierig präzise Ertragsmessung selbst bei großen Experimenten sein kann. Lewis und Rao untersuchen 25 große Feldexperimente und berichten breite Unsicherheitsintervalle für Werberenditen. Das ist ein Argument für realistische Erwartungen, nicht gegen jedes Experiment. [11]
Halte die Ergebnisse in einem Lernarchiv fest: Problem, Zielgruppe, Varianten, Messdefinition, vorab geplanter und tatsächlicher Ablauf, Rohzahlen, Effektschätzung, Unsicherheit, Einschränkungen und Entscheidung. Bewahre auch negative und unklare Tests auf. Sonst sieht die Organisation nur die zufälligen Gewinner.
Was bei wenig Reichweite sinnvoller sein kann
Ein Unternehmen mit 20 qualifizierten Anfragen im Monat kann kleine Unterschiede der Abschlussrate oft nicht in einer praktikablen Zeit präzise messen. Erfinde dann keine Sicherheit durch eine kleine pauschale Mindeststichprobe. Mache den Testplan und seine Grenzen sichtbar. Ressourcenbedingte Stichproben sind legitim, beantworten aber möglicherweise nur große Effekte ausreichend genau. [3]
Prüfe zuerst starke, belegte Hürden: Ist das Angebot verständlich? Funktioniert das Formular? Fehlen Preiseinordnung, Nachweise oder ein klarer nächster Schritt? Moderierte Nutzungstests, Kundeninterviews und systematische Vertriebsrückmeldungen können Mechanismen und Fehler aufdecken. Sie schätzen jedoch keinen zufallsbereinigten prozentualen Conversion-Uplift.
Weitere Optionen sind ein fachlich stärkerer Variantenkontrast, eine längere saubere Datensammlung oder ein gemeinsamer Test wirklich vergleichbarer Seiten. Das Zusammenlegen heterogener Angebote, Saisons oder Zielgruppen darf keine unbegründete Durchschnittsaussage erzeugen. Wenn wirtschaftlich sinnvolle Effekte mit vorhandenen Daten nicht prüfbar sind, ist eine Entscheidung unter dokumentierter Unsicherheit ehrlicher als ein Scheinsieger.
Werkzeuge, Datenschutz und technische Umsetzung
Wähle ein Werkzeug nach deinem Versuchsaufbau: stabile Zufallszuweisung, dokumentierte Einheiten, korrekte Ausschlüsse, Export von Roh- beziehungsweise Aggregatdaten, Diagnose der Zuteilung, passende Statistik und nachvollziehbare Versionen. Prüfe, ob es im Browser Inhalte austauscht, serverseitig Varianten ausliefert oder eine echte E-Mail-Experimentfunktion anbietet. Ein kurz sichtbarer Wechsel der Seite kann das Nutzererlebnis und den Versuch beeinflussen.
Google Optimize wurde am 30. September 2023 eingestellt. Eine aktuelle Werkzeugliste darf es deshalb nicht als verfügbare Standardlösung empfehlen. Für die Auswahl sind überprüfbare Anforderungen hilfreicher als ein unveränderter Katalog von Produktnamen. [12]
Datenschutz beginnt bei Zweck, Rechtsgrundlage, Datenminimierung, Aufbewahrung und Auftragsverarbeitung. Zusätzlich ist beim Speichern oder Auslesen von Informationen auf Endgeräten § 25 TDDDG zu prüfen. „Ohne Cookies“ oder „serverseitig“ bedeutet nicht automatisch einwilligungsfrei. Die endgültigen EDSA-Leitlinien zum technischen Anwendungsbereich behandeln unter anderem Tracking-Pixel und Tracking-Links. [13][14]
Übermittle keine Namen oder E-Mail-Adressen in Analyse-URLs. Trenne notwendige Betriebsfunktionen von optionaler Messung, respektiere die getroffene Datenschutzentscheidung und dokumentiere, welche Zielgruppe dein Test dadurch tatsächlich abbildet. Ein Test unter einwilligenden Besuchern muss nicht dieselbe Wirkung für alle Besucher haben. Sicherheits- und Datenschutzfragen gehören vor den Start.
Dein Ablauf von der Idee bis zum Lernarchiv
- Problem belegen: Kundenhürde und Geschäftsziel anhand vorhandener Informationen beschreiben.
- Hypothese formulieren: Zielgruppe, Änderung, Mechanismus und erwartete Wirkung festhalten.
- Messung definieren: Hauptkennzahl, Nenner, Fenster und Schutzkennzahlen festlegen.
- Versuch planen: Einheit, Zuteilung, Mindestwirkung, Stichprobe und Auswertungsregel dokumentieren.
- Technik prüfen: Varianten, Events, Consent, Bots, Geräte und Fehlerfälle kontrollieren.
- Kontrolliert starten: Änderungen versionieren und die Zuteilungsqualität überwachen.
- Planmäßig beenden: Datenfenster ausreifen lassen; Abweichungen offen dokumentieren.
- Vollständig auswerten: Rohzahlen, Effekt, Unsicherheit, Schutzkennzahlen und Mehrfachprüfungen berichten.
- Wirtschaftlich entscheiden: Nutzen, Kosten, Reversibilität und Risiken zusammenführen.
- Wissen sichern: Ergebnis und Grenzen archivieren; Einführung nachbeobachten.
Für die Umsetzung arbeiten Marketing, Vertrieb, Technik und gegebenenfalls Datenschutz zusammen. Bestimme eine verantwortliche Person für die Entscheidung und eine für die Datenprüfung. Gerade im Mittelstand verhindert diese klare Zuständigkeit, dass ein Dashboard-Wert ungeprüft zur Unternehmensentscheidung wird.
Häufige Fragen zu A/B-Tests
Reichen 100 Conversions pro Variante?
Es gibt keine allgemeingültige Zahl. Ausgangsrate, relevante Wirkung, Streuung und Design bestimmen, was sich erkennen lässt. Plane mit deiner Fragestellung statt mit einer pauschalen Faustregel.
Darf ich während eines Tests ins Dashboard schauen?
Ja, etwa zur technischen und betrieblichen Kontrolle. Wirkungsaussagen und vorzeitige Entscheidungen müssen jedoch zur geplanten statistischen Regel passen. Häufiges gewöhnliches Signifikanztesten mit Stopp beim ersten Erfolg ist problematisch.
Muss ich immer nur ein Element verändern?
Nein. Ein Gesamtentwurf kann gegen die bisherige Version antreten. Du erfährst dann die Wirkung des Pakets. Um Einzelbeiträge oder Wechselwirkungen zu bestimmen, braucht es einen entsprechenden Versuchsplan.
Ist eine höhere Klickrate schon ein Erfolg?
Nur wenn sie zur eigentlichen Zielentscheidung passt. Prüfe qualifizierte Anfragen, Verkäufe, Deckungsbeiträge und mögliche Schäden. Mehr Neugier kann auch mehr unpassende Kontakte bedeuten.
Was mache ich bei einem unklaren Ergebnis?
Dokumentiere die Unsicherheit. Prüfe, welche geschäftlich relevanten Effekte noch mit den Daten vereinbar sind. Entscheide nach dem vorab geplanten Verfahren über Beibehaltung, einen neuen Versuch oder eine vorsichtige betriebliche Entscheidung.
Quellen und Einordnung
Die methodischen Aussagen stützen sich auf wissenschaftliche Originalarbeiten und Dokumentationen der Autoren beziehungsweise Fachorganisationen. Die Quellenhinweise unterscheiden frei zugängliche Arbeiten, Verlagszusammenfassungen und offizielle technische Vorgaben. Rechenbeispiele und Arbeitsvorlagen stammen von uns und sind keine berichteten Kundenergebnisse. Rechtliche und technische Hinweise beziehen sich auf den Prüfstand 28. Oktober 2026 und müssen zur konkreten Umsetzung passen.
- Kohavi, Henne & Sommerfield (2007): Practical Guide to Controlled Experiments on the Web
Wissenschaftlicher Methodenbeitrag; frei zugängliche Autorenfassung. Grundlage für Randomisierung und praktische Versuchsplanung. - Bojinov & Gupta (2022): Online Experimentation: Benefits, Operational and Methodological Challenges, and Scaling Guide
Harvard Data Science Review, DOI 10.1162/99608f92.a579756e. Frei zugängliche methodische Arbeit; einschlägige Abschnitte zu Kennzahlen, Abhängigkeiten und Langfristwirkung geprüft. - Lakens (2022): Sample Size Justification
Collabra: Psychology 8(1), 33267, DOI 10.1525/collabra.33267. Frei zugänglicher Methodenartikel zur Begründung von Stichproben. - American Statistical Association (2016): Statement on Statistical Significance and P-Values
Offizielle Erläuterung der sechs Grundsätze der Fachgesellschaft. Kein Beleg für eine bestimmte geschäftliche Entscheidungsschwelle. - Johari et al.: Always Valid Inference: Continuous Monitoring of A/B Tests
Operations Research, DOI 10.1287/opre.2021.2135. Wissenschaftliche Originalarbeit zu gültigen Verfahren bei kontinuierlicher Beobachtung. - Fabijan et al. (2019): Diagnosing Sample Ratio Mismatch in Online Controlled Experiments
KDD-Forschungsbeitrag; offizieller Publikationseintrag der Autorenorganisation. Ergänzend wurde deren frei zugängliche Methodenerläuterung zur SRM-Diagnose herangezogen. - Dmitriev et al. (2017): A Dirty Dozen: Twelve Common Metric Interpretation Pitfalls in Online Controlled Experiments
Wissenschaftlicher Methodenbeitrag; offizieller Forschungseintrag. Grundlage für die Einordnung von Nennern und Auswahlproblemen. - Lakens (2017): Equivalence Tests: A Practical Primer
Social Psychological and Personality Science, DOI 10.1177/1948550617697177. Frei zugängliche Originalarbeit; Grundprinzip der Äquivalenzprüfung, nicht ein fertiger Test für alle Marketingkennzahlen. - R Core Team: Power Calculations for Two-Sample Test for Proportions
Primärdokumentation zur Planung zweier Anteile; n bezeichnet die Zahl je Gruppe. Die im Artikel gezeigte Näherungsrechnung wird ausdrücklich mit Annahmen erläutert. - R Core Team: Adjust P-values for Multiple Comparisons
Primärdokumentation zu Holm, Benjamini–Hochberg und weiteren Korrekturen; die Verfahren kontrollieren unterschiedliche Fehlerbegriffe. - Lewis & Rao (2015): The Unfavorable Economics of Measuring the Returns to Advertising
Quarterly Journal of Economics, DOI 10.1093/qje/qjv023. Verlagsabstract geprüft; berichtet Unsicherheit aus 25 großen Feldexperimenten. Kein frei geprüfter Volltext. - Google: Google Optimize sunset
Offizielle Produktinformation zur Einstellung von Google Optimize und Optimize 360 am 30. September 2023. - Bundesministerium der Justiz: § 25 TDDDG
Amtlicher Gesetzestext; Schutz von Informationen in Endeinrichtungen. Die historische URL enthält weiterhin „ttdsg“. - EDSA (2024): Guidelines 2/2023 on Technical Scope of Article 5(3) of ePrivacy Directive
Endgültige Leitlinien, angenommen am 16. Oktober 2024; offizielle Auslegung, unter anderem zu Pixeln und Tracking-Links.
Bildhinweis: Die ausdrücklich gekennzeichneten KI-Visualisierungen erklären Konzepte. Sie zeigen keine realen Kundenprojekte oder Software-Screenshots. Eigene Schaubilder und Rechenbeispiele sind entsprechend bezeichnet.